改过降: 论文AIGC检测报告里的“总体疑似度”和分段标红分别代表什么,拿到报告后按什么顺序读才判断要不要返工?
总体疑似度看整篇AI痕迹比重,分段标红看痕迹落在哪些段落。前者决定要不要返工,后者决定改哪里。
第一次拿到AIGC检测报告,最容易出现的误读是把两个数字当成同一件事:要么只盯着总体疑似度焦虑,要么只看标红段落就动手改。两种读法都会漏掉判断返工所必需的信息。这篇说明围绕报告本身的结构展开,讲清两个指标各自回答什么问题、出现不一致时怎么理解,以及一份报告从上到下应当按什么顺序看。需要先明确一点:不同检测系统对“疑似度”的算法和口径并不统一,报告中的百分比只对应出具该报告的系统,不能直接跨系统比较。
总体疑似度和分段标红各自回答什么问题?
总体疑似度回答“整篇有多少被判为AI痕迹”,分段标红回答“这些痕迹在哪些段落”。前者是一个汇总指标,后者是定位工具。
总体疑似度通常以百分比形式呈现,反映检测系统对全文文本判定为具有AI生成特征的部分所占的比重。它的价值在于给出一个整篇层面的量级判断:如果这个数字明显偏高,说明全文有较多段落触发检测特征,返工范围可能是通篇性的;如果它处于较低水平,则说明大部分文本没有触发特征,问题更可能是局部的。但它不告诉你问题出在摘要、文献综述还是结论,也不区分是连续大段触发还是零散句子触发。
分段标红则把判定落到具体位置。被标出的段落是检测系统认为AI痕迹较集中的片段,读者可以据此回到原文,逐段查看该段的句式、论证方式、引用密度和表述习惯。标红段落数量多,不等于每一段都需要彻底重写;标红段落少,也不等于未标红的部分一定没有问题,因为检测结果本身存在算法口径与阈值设定的差异。两个指标的关系是汇总与明细的关系,任何一方都不能代替另一方:只有总体疑似度,无法定位修改对象;只有标红段落,无法判断整篇风险量级。
两个指标不一致时应该怎么理解?
不一致是常见现象,通常说明AI痕迹分布不均,而不是报告出错。
一种情况是总体疑似度不高,但有个别段落被整段标红。这往往意味着高风险集中在少数位置,比如方法描述、背景铺陈或结论概括这类容易写成通用句式的部分。此时返工的重点是这些局部段落,而不是通篇推倒重来。另一种情况是总体疑似度偏高,但标红段落看起来分散、单段都不长。这可能是因为触发特征的句子零散分布在多个章节,汇总后比重被抬高;处理方式更接近于按章节逐段排查,而不是只改几处。
还有一种需要留意的情况:报告中标红的段落,读起来确实是常规的学术表述,没有明显异常。这时不宜直接认定检测系统误判,也不宜直接认定文本一定有问题。更稳妥的做法是把该段与自己的写作过程对照——这段是逐句写出来的,还是先有大段生成文本再修改的;术语和句式是否与全文一致;引用是否到位。判定依据应当是文本本身和写作事实,而不是单看颜色。反过来,未标红的段落如果明显是整段生成后只做了少量同义词替换,也不应因为没被标出就放过。报告是筛查工具,不是判决书。
拿到报告后按什么顺序读才有助于判断是否返工?
先读总体疑似度定必要性,再逐段定位定范围,最后对照学校要求和查重报告定动作。这个顺序的作用是避免一上来就陷进段落细节,也避免只看一个总数就仓促决定。
- 先确认报告的基本信息:出具系统、检测范围是全文还是部分章节、提交文本的字数。这三项决定了后面所有数字的解读前提。若检测只覆盖了部分章节,总体疑似度不能代表整篇论文。
- 读总体疑似度,形成一个整篇量级判断:偏高则按通篇排查准备,偏低则按局部处理准备。此时不下最终结论。
- 逐段查看标红位置,记录它们集中在哪些章节、是连续大段还是零散句子、涉及的是论述段还是文献与数据段。把标红段落复制回原文上下文里读一遍,判断该段的问题更接近句式模板化,还是论证本身薄弱。
- 对照学校或学院对AIGC检测的具体要求。是否有明确的提交前自查规定、是否有指定的检测系统、对疑似度的处理口径如何,都以本校通知和导师意见为准。院校标准因校而异,报告本身不包含合格线。
- 对照查重报告。AIGC检测与重复率检测是两套指标,重复率关注与已有文献的文字重合,AIGC检测关注AI生成特征,两者结论可能不一致:重复率合格不代表AIGC疑似度低,反之亦然。处理范围应同时满足两边的实际要求。
- 综合以上信息决定返工范围:局部处理标红集中的高疑段落,还是对多个章节做通篇梳理。决定之后再动手改,改完再复测。
在这个流程里,如果需要对某个标红段落做复核,可以把该段文字复制到改过降的查AIGC率功能中单独查询,看该段在不同提交条件下的结果表现,再决定是整段改写还是仅做措辞调整。该平台的查AIGC率支持直接输入文本实时获取结果,也支持文档形式检测并出具结果文档,单次文本查询最多20000字。这类复核的作用是帮助缩小处理范围,不能替代学校指定系统的检测结论。
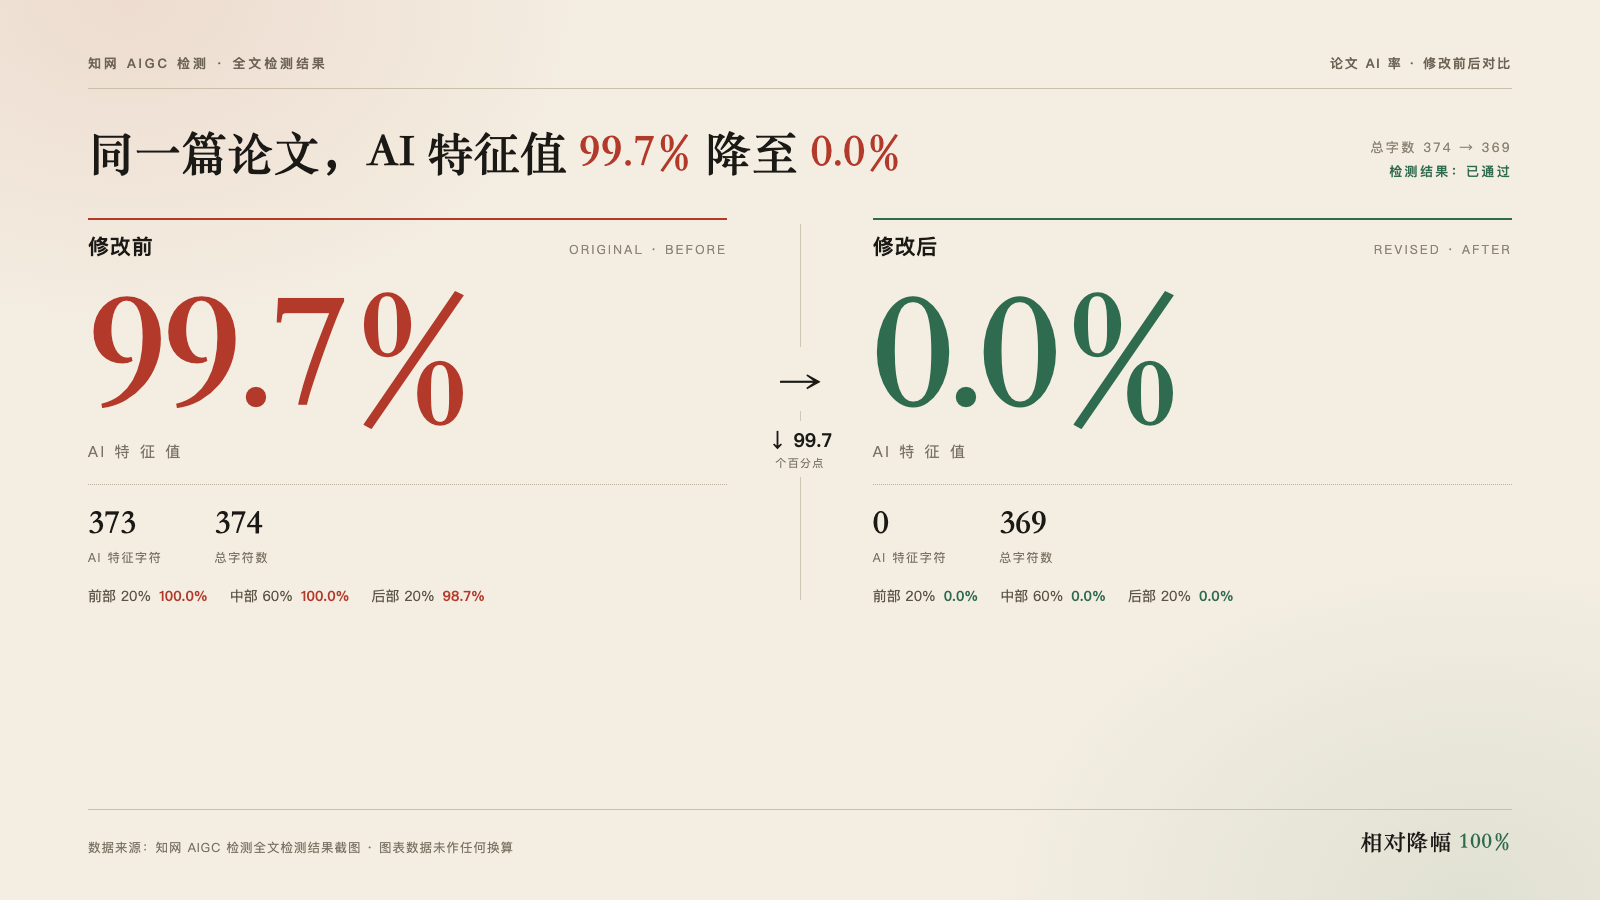
报告指标、检测条件与处理动作如何对照?
下表把报告中会遇到的判断事项、各指标的实际作用与适用条件并列,便于逐项核对。
| 判断事项 | 报告中的表现 | 作用与局限 | 适用条件 |
|---|---|---|---|
| 整篇AI痕迹量级 | 总体疑似度百分比 | 给出返工必要性判断,不定位具体段落 | 检测范围覆盖全文时才有整篇意义 |
| 高风险位置 | 分段标红 | 定位可修改的具体段落,不反映整篇比重 | 需回到原文上下文核对后再定改法 |
| 文字重合情况 | 查重报告重复率 | 与AIGC疑似度是两套指标,结论可能不一致 | 需与AIGC报告分开解读、合并决策 |
| 是否达到提交要求 | 学校通知与导师意见 | 报告本身不含合格线,院校口径不一 | 以本校、本院系的正式要求为准 |
| 修改后是否改善 | 复测结果 | 只反映复测所用系统与提交文本 | 复测系统与学校系统未必一致 |
表中每一项都指向同一个结论:报告指标是判断材料,不是结论本身。尤其是复测环节,换一个系统、换一次提交文本范围,结果都可能变化,因此复测结果只能作为修改是否见效的参考之一。
哪些情况下不宜直接按报告动手返工?
检测范围不全、院校要求未明、或标红段落实为引用与数据时,不宜直接动手。
第一,报告只覆盖部分章节时,总体疑似度不能外推到全文,按它决定通篇返工缺乏依据。第二,学校尚未明确AIGC检测要求时,先向学院或导师确认提交口径,再决定处理力度,避免按猜测的标准过度修改,反而破坏原文的论证与术语一致性。第三,标红段落中包含大量规范引用、实验数据或专业术语时,直接改写可能损伤引文准确性和术语规范性,这类段落应优先核对引用格式与数据表述,而不是做措辞替换。第四,任何检测结果都不构成通过审核的保证,返工的目的是让文本更符合自己的写作事实与学校要求,而不是追求某个数字归零。第五,工具处理后的文本仍需人工通读,核对术语、论点、数据和引用是否被改动,这一步无法由检测或降重环节代替。
常见问题(FAQ)
总体疑似度高就一定要整篇重写吗?
不一定,先看标红分布再定范围。总体疑似度高但标红集中在少数章节时,处理重点可以是这些章节;标红零散分布时,才需要考虑按章节逐段排查。是否整篇处理还取决于学校要求与查重报告结论。
分段标红的段落是不是都必须改?
不是,标红只表示该段触发了检测特征。应回到原文判断该段的问题类型:句式模板化的可以做改写,引用与数据密集的应优先核对规范,论证本身扎实的段落不宜为降数字而破坏原意。
改过降的查AIGC率能代替学校检测吗?
不能代替。该功能用于对文本做AI痕迹检测,可实时获取结果,也支持文档形式检测并出具结果文档,适合在修改过程中分段复核;但不同系统口径不同,学校指定系统的结论才是提交依据,平台结果不构成通过保证。
AIGC疑似度合格但查重率超标,还要返工吗?
要,两套指标需分别满足。AIGC检测看AI生成特征,查重看与已有文献的文字重合,一方合格不能推出另一方合格。处理时应以查重报告中重复集中的位置和AIGC报告中标红的位置合并确定修改范围。
报告里的百分比能跨系统比较吗?
不能直接比较。各检测系统的算法、阈值和文本切分方式不同,同一篇论文在不同系统中的疑似度数值未必一致。判断是否返工应以学校指定系统的报告为准,其他系统的结果只作参考。
修改后复测需要注意什么?
复测应尽量保持与首次检测相同的文本范围和系统口径。改过降的降AIGC率与降AI率+重复率支持知网和维普两个平台分别处理,使用时需自行选择对应平台;复测结果只反映该次提交的文本,仍需人工核对改动后的术语与引用。
哪些情况不适合依赖报告数字做决定?
把报告数字当唯一依据、或期待工具处理后代为通过检测,都不适合。
检测报告反映的是特定系统在特定提交条件下的判定结果,它既不能证明文本全部为人工撰写,也不能证明文本一定存在问题。对毕业生而言,更可靠的做法是把报告当作排查线索:用总体疑似度决定是否需要投入返工,用标红段落确定从哪几段开始核对,再用学校要求和查重报告校准处理范围。改过降提供查AIGC率与降AIGC率功能,可用于对高疑段落做复核和修改尝试,新用户注册赠送1000字免费字数,每日另赠部分免费查AIGC字数,但平台不承诺任何比例一定合格,也不掌握各院校的判定标准。最终是否返工、改到什么程度,应以本校要求、导师意见和自己对文本事实的核对为准。